Fating Hong/洪发挺
fating.hongkaust.edu.sa; fatinghonggmail.com
Biography
I am a postdoctoral fellow at the King Abdullah University of Science and Technology (KAUST), working with Prof. Peter Wonka. I received my Ph.D. in Computer Science from the Hong Kong University of Science and Technology (HKUST), advised by Prof. DAN XU. I received my master's degree in 2021 at Sun Yat-sen University, where I was advised by Prof. Wei-Shi Zheng and researched in video understanding.
Resume

Education
- 08/2021 ~ 05/2026: PhD, Department of Computer Science & Engineering, Hong Kong University of Science and Technology
- 09/2018 ~ 07/2021: Computer Science and Technology, Sun Yat-sen University
- 09/2014 ~ 07/2018: Computer Science and Technology, South China University of Technology
Research interests
- Visual-Audio Learning
- Avatar Generation/Animation
- Human Motion Generation/Editing
News
- (Feb 2026): Our paper Identity-Preserving Video Dubbing Using Motion Warping is accepted by IJCV 2026!
- (Jan 2026): 2 paper accepted by ICASSP 2026!
- (Jun 2025): 2 paper accepted by ICCV 2025!
- (Feb 2025): 4 papers accepted by CVPR 2025!
- (Dec 2024): Our paper AnyTalk is accepted by AAAI 2025, stay tuned!
- (Oct 2024): Start my internship at Hunyuan, Tencent.
- (Sep 2024): Our temporal action localization work is accepted by TCSVT (Finally).
- (May 2024): Start my internship at Adobe, U.S.
Preprints


OmniInteract: Towards Unified Whole-Body Interaction Control for Dual Humanoids
Yinghao Li, Tianyu Zhang, Zhuohao Li, Yi-Lin Wei, Fa-Ting Hong, Qing Zhang, Wei-Shi Zheng
ArXiv 2026


TACD: Distilling Efficient Text-to-Motion Models via Terminal Amplification Control
Wei-Jin Huang, Yuan-Ming Li, Kun-Yu Lin, Wang Luo, Yinlin Zhu, Yue Yu, Shenghao Ye, Junbin Yuan, Fa-Ting Hong, Qing Zhang, Wei-Shi Zheng
ArXiv 2026


EfficientSync: Real-Time Lip Synchronization via Deformation-Based Reference Texture Mixing
Fa-Ting Hong*, Runzhen Liu*, Luchuan Song, Hongmin Cai, Chuhua Xian
ArXiv 2026


Selected Publications


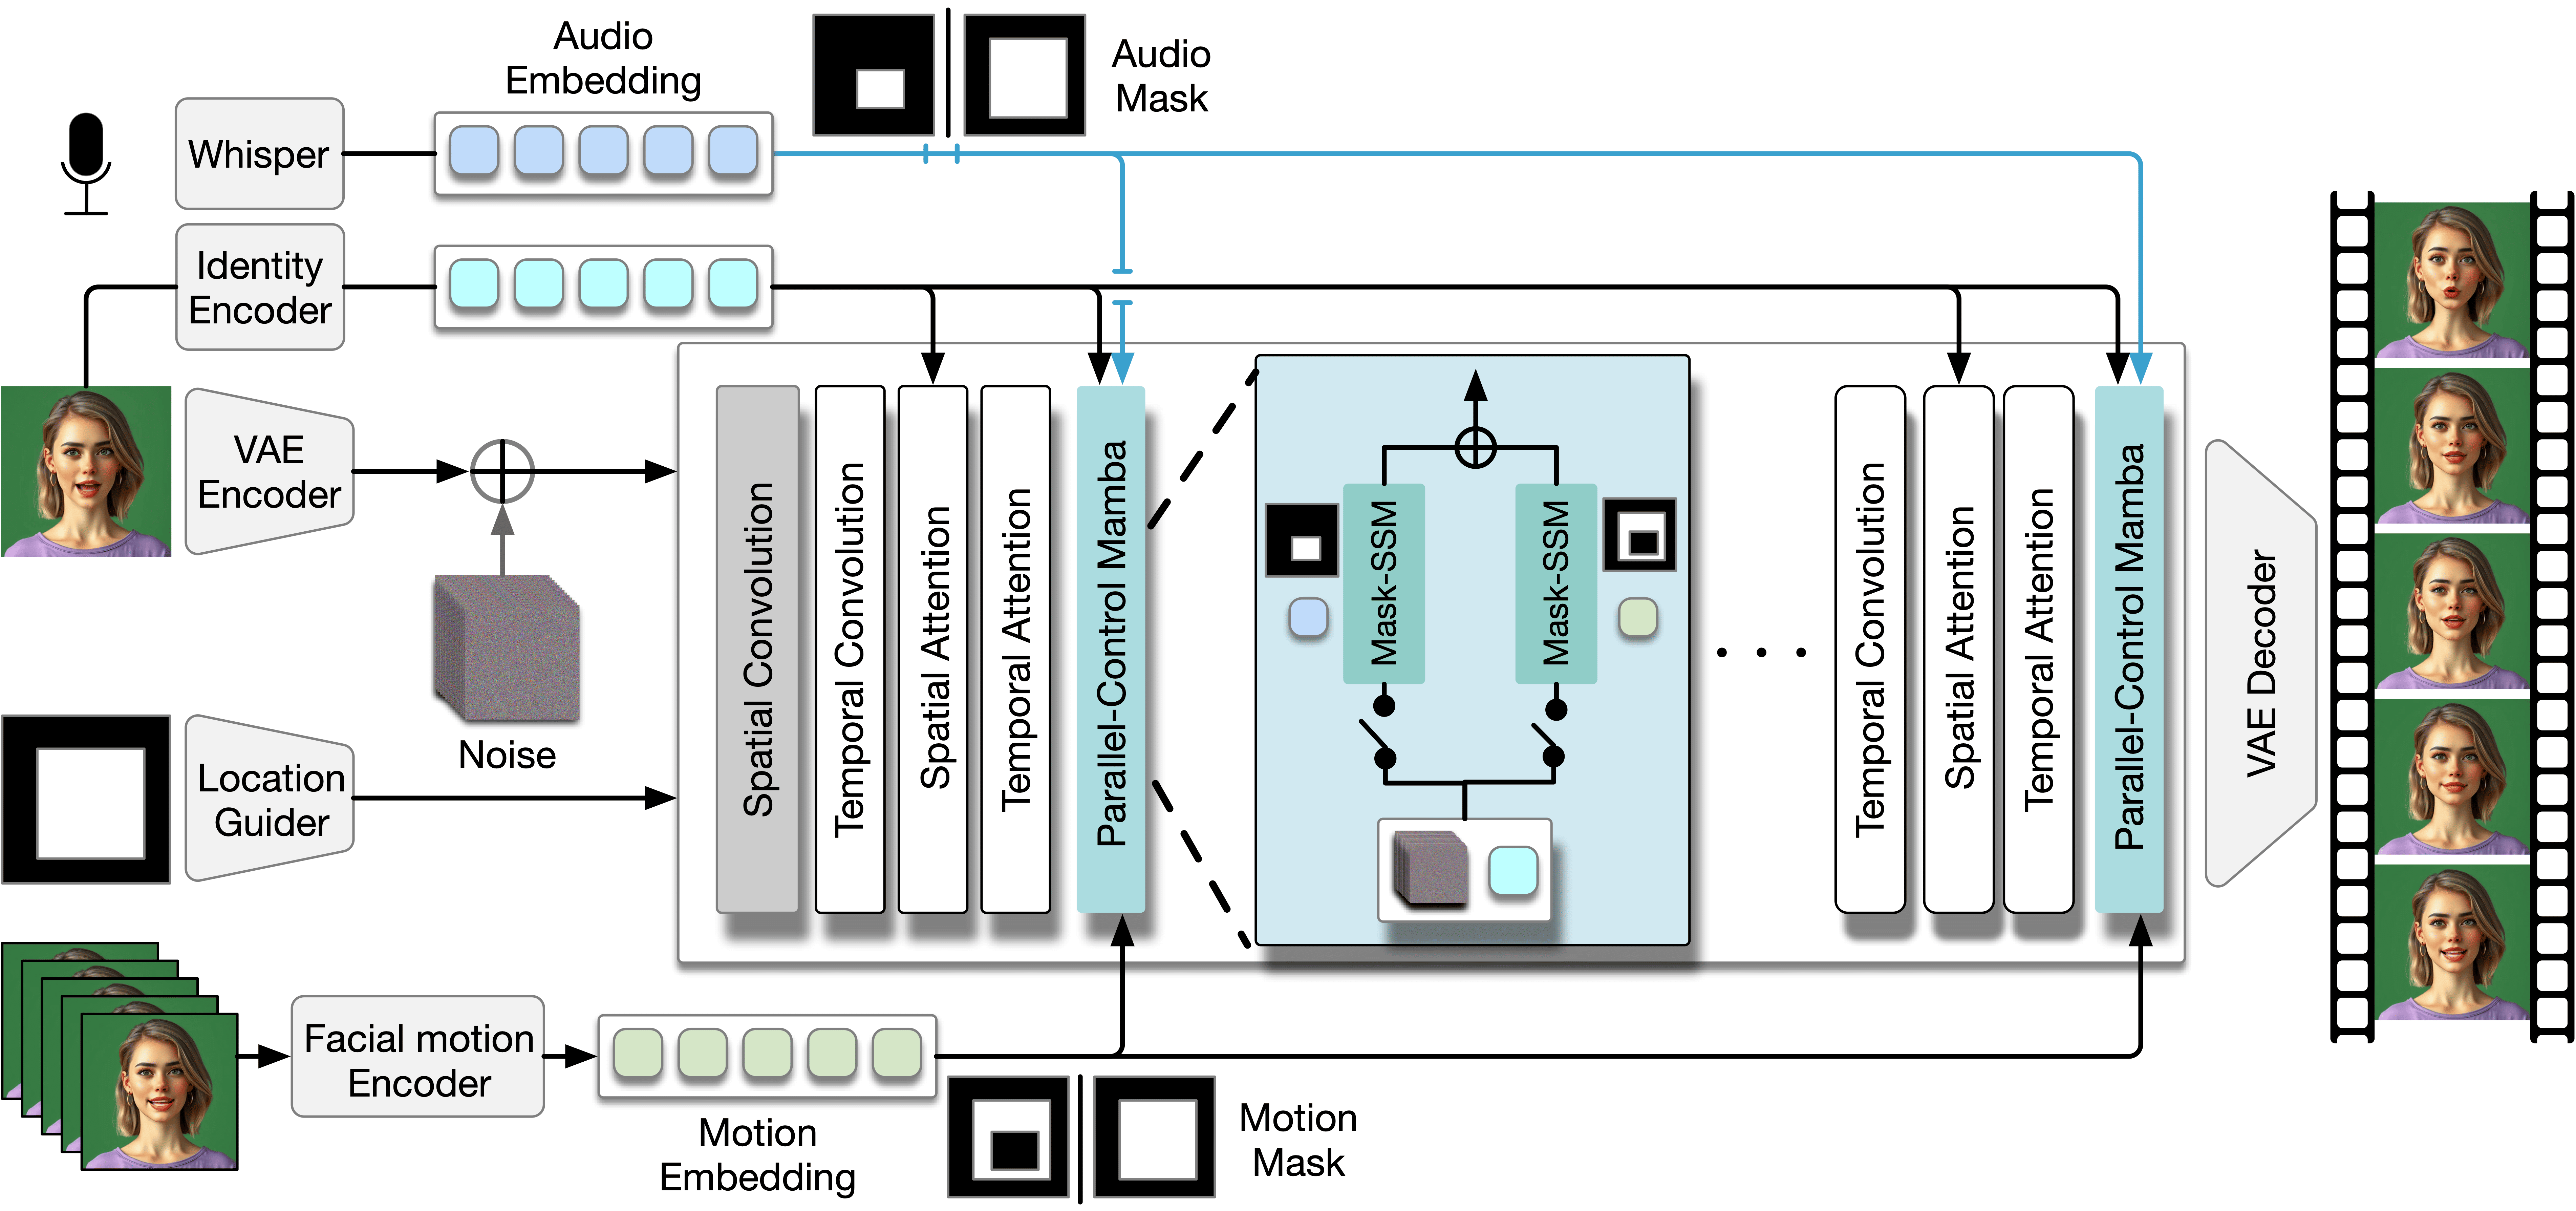
Audio-visual Controlled Video Diffusion with Masked Selective State Spaces Modelling for Natural Talking Head Generation
Fa-Ting Hong, Zunnan Xu, Zixiang Zhou, Jun Zhou, Xiu Li, Qin Lin, Qinglin Lu, Dan Xu
ICCV 2025
Code |
ArXiv |
Project Page


Video Motion Graphs
Haiyang Liu, Zhan Xu, Fa-Ting Hong, Hsin-Ping Huang, Yi Zhou, Yang Zhou
ICCV 2025

HunyuanPortrait: Implicit Condition Control for Enhanced Portrait Animation
Zunnan Xu, Zhentao Yu, Zixiang Zhou, Jun Zhou, Xiaoyu Jin, Fa-Ting Hong, Xiaozhong Ji, Junwei Zhu, Chengfei Cai, Shiyu Tang, Qin Lin, Xiu Li, Qinglin Lu
CVPR 2025
Code |
ArXiv |
Project Page

FireEdit: Fine-grained Instruction-based Image Editing via Region-aware Vision Language Model
Jun Zhou, Jiahao Li, Zunnan Xu, Hanhui Li, Yiji Cheng, Fa-Ting Hong, Qin Lin, Qinglin Lu, Xiaodan Liang
CVPR 2025


Synergizing Motion and Appearance: Multi-Scale Compensatory Codebooks for Talking Head Video Generation
Shuling Zhao, Fa-Ting Hong, Xianshui Huang, Dan Xu
CVPR 2025
Code |
ArXiv |
Project Page

Free-viewpoint Human Animation with Pose-correlated Reference Selection
Fa-Ting Hong, Zhan Xu, Haiyang Liu, Qinjie Lin, Luchuan Song, Zhixin Shu, Yang Zhou, Duygu Ceylan, Dan Xu
CVPR 2025 (Highlight, 13.5% of accepted papers)
Code |
ArXiv |
Project Page


Implicit Identity Representation Conditioned Memory Compensation Network for Talking Head video Generation
Fa-Ting Hong, Dan Xu
ICCV 2023
Code |
Paper |
Project Page


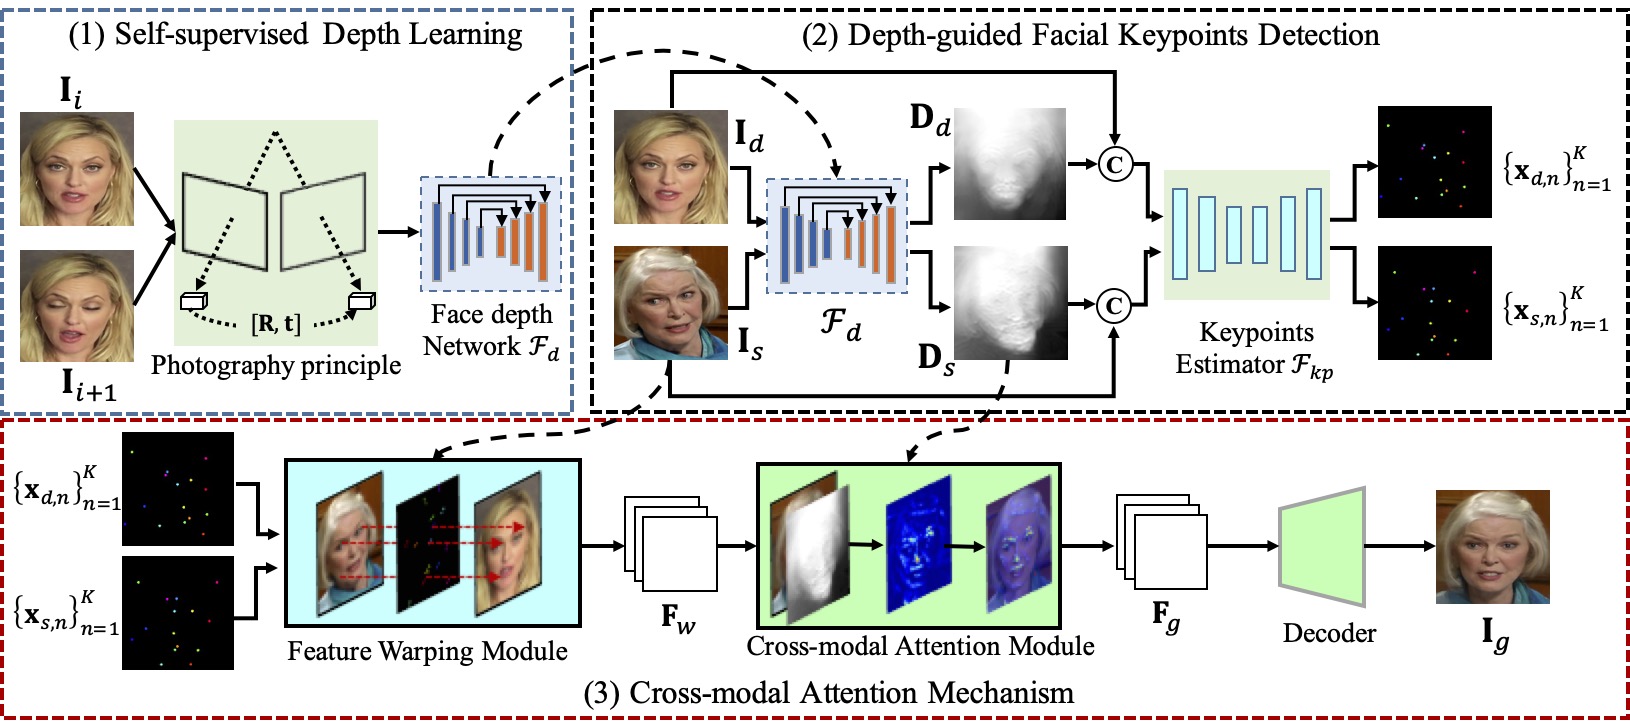
Depth-Aware Generative Adversarial Network for Talking Head Video Generation
Fa-Ting Hong, Longhao Zhang, Li Shen, Dan Xu
CVPR 2022
Code |
Paper |
Project Page


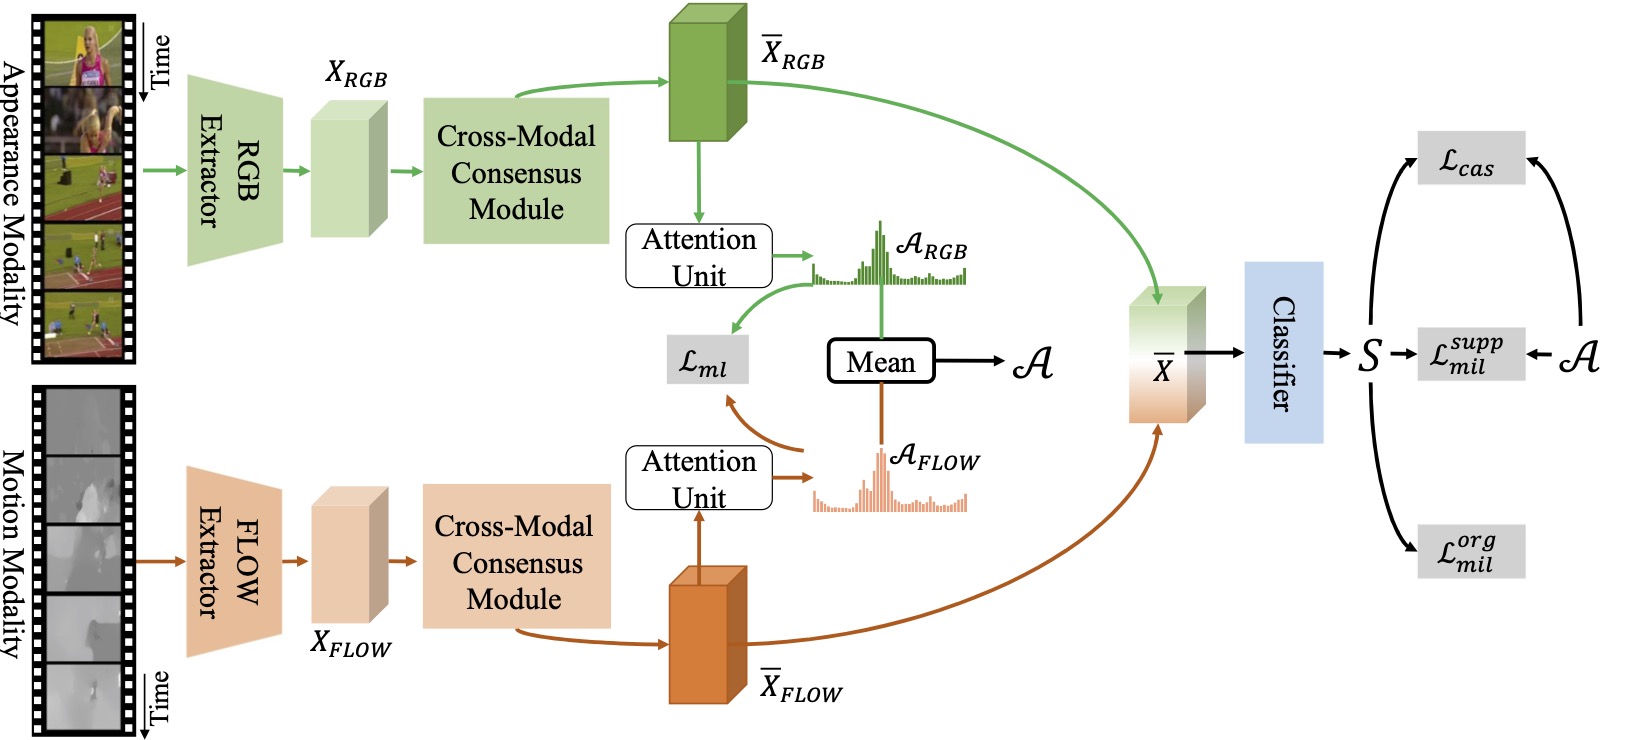
Cross-modal Consensus Network for Weakly Supervised Temporal Action Localization
Fa-Ting Hong, Jia-Chang Feng, Dan Xu, Ying Shan and Wei-Shi Zheng
ACM MM 2022


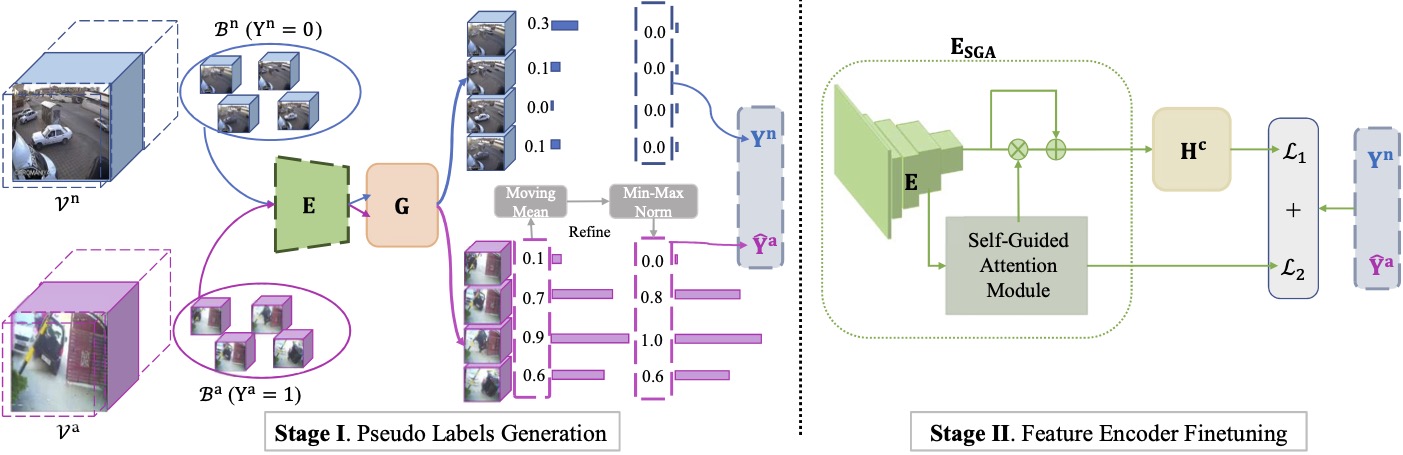
MIST: Multiple Instance Self-Training Framework for Video Anomaly Detection
Jia-Chang Feng, Fa-Ting Hong, Wei-Shi Zheng
CVPR 2021
Code |
Paper |
Project Page


Hybrid Dynamic-static Context-aware Attention Network for Action Assessment in Long Videos
Ling-An Zeng, Fa-Ting Hong, Wei-Shi Zheng#, Qi-Zhi Yu, Wei Zeng, Yao-Wei Wang, and Jian-Huang Lai


MINI-Net: Multiple Instance Ranking Network for Video Highlight Detection
Fa-Ting Hong, Xuanteng Huang, Wei-Hong Li, Wei-Shi Zheng
ECCV 2020
Code |
Paper |
Project Page


Intern Experience
-
23.06 — 05.12 2025
 Meta
– RL Research Gemini, Zurich
1.11 — 19.03 2024-2025
 Tencent
– Hunyuan Lab
24.5 — 24.8 2024
 Adobe Research
– Media Intelligence Lab, San Jose
Academic Services
- Reviewer: ICLR, CVPR, ECCV, SIGGRAPH Asia, ACMMM, TPAMI, ICCV, NeurIPS, TMM, IJCV
Statistics